

TimescaleDB 是 PostgreSQL 的时序扩展,用超表与连续聚合把时序数据的写入、压缩和查询效率提升到新高度。本文手把手演示落地。
 2026-09-10
从发布与订阅两大核心对象入手,手把手搭建 PostgreSQL 逻辑复制,实现表级实时同步、行级过滤与异构数据分发,并避开主键缺失、DDL 不复制、复制槽泄漏三大生产坑。
2026-09-09
Elasticsearch 是基于倒排索引的分布式搜索引擎。本文从索引设计、全文检索到聚合分析,给出可直接落地的实战示例,帮你快速搭建搜索与数据分析能力。
2026-09-08
生产环境 MySQL 死锁如何快速定位与根治?本文用可复现的并发更新案例,详解 InnoDB 死锁检测、SHOW ENGINE INNODB STATUS 日志解读与六类预防手段。
2026-09-07
Elasticsearch 全文检索凭借倒排索引与分布式架构,能在毫秒级返回相关性排序结果。本文从倒排索引原理讲起,覆盖 DSL 查询、BM25 相关性调优、ik 中文分词与性能排查,落地一条可上生产的搜索链路。
2026-09-06
单表上亿行后查询与维护都变慢?PostgreSQL 分区表按 Range/List/Hash 把大表拆成子表,查询只扫命中分区、清理旧数据可毫秒级 DETACH。本文讲透建表、分区剪枝、索引策略与大表在线改造。
2026-09-03
ClickHouse 用列式存储与排序键稀疏索引,把亿级数据实时分析做成一件很便宜的事。本文从行存列存差异讲到 MergeTree、分区排序键设计与查询优化实战。
2026-09-01
单机 Redis 撑不住高并发与大数据量时,Redis 集群用 16384 个哈希槽把数据打散到多节点,配合主从复制实现故障自动转移。本文讲清分片原理、六节点搭建、客户端接入与扩容缩容的实战要点。
2026-09-01
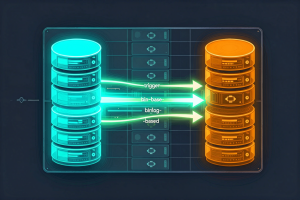
在线改大表实战:用 pt-online-schema-change 与 gh-ost 实现零停机 DDL,对比原理、坑点与选型,与 Flyway 版本化迁移形成互补。
2026-08-31
MySQL 备份恢复实战:讲清 mysqldump 逻辑备份与 XtraBackup 物理备份的选型差异,并用 binlog 完成时间点恢复(PITR),附可直接照抄的备份脚本与恢复演练清单。
2026-08-30