MoE 混合专家模型(Mixture of Experts,混合专家)正成为主流大模型的默认架构。从 Mixtral、DeepSeek 到 Qwen,参数规模突破千亿却仍能保持可控的推理成本,靠的正是用”多个专家网络 + 门控路由”替换 Transformer 中原本单一的 FFN 前馈层。本文拆解 MoE 的工作原理、路由机制与工程落地要点,帮你搞懂它为什么能在”参数翻倍”的同时把”激活算力”压住。
一、MoE 混合专家模型到底是什么
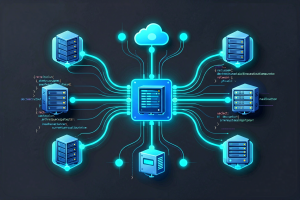
传统稠密模型(Dense)每一层的前馈网络对所有 token 一视同仁:不管输入什么,全部参数都会参与计算。MoE 的思路是”分而治之”——把一层 FFN 拆成 N 个并行的”专家”子网络,再增加一个门控网络(Router / Gate),由它决定每个 token 该交给哪几个专家处理。
关键在于”稀疏激活”:一次前向传播里,每个 token 只经过少数几个专家,而不是全部。于是总参数量可以做得很大(容纳更多知识),但单次的激活参数却很小(算力可控)。这正是 MoE 用”大力出奇迹”又不”烧钱”的核心。值得注意的是,MoE 并不是免费午餐:它把算力瓶颈换成了显存与路由复杂度瓶颈,因此是否值得上 MoE,取决于你的业务到底受限于训练与推理算力,还是受限于显存与部署成本。
二、门控路由:token 如何被分派
门控网络本质是一个线性层,把 token 的隐向量映射成每个专家的得分,再取 softmax 得到概率分布,最后按 Top-k 选出得分最高的 k 个专家。下面是一段最小可运行的 PyTorch 风格实现:
import torch, torch.nn as nn
import torch.nn.functional as F

class MoELayer(nn.Module):
    def __init__(self, dim, num_experts=8, top_k=2):
        super().__init__()
        self.experts = nn.ModuleList(
            [nn.Linear(dim, dim) for _ in range(num_experts)])
        self.gate = nn.Linear(dim, num_experts, bias=False)
        self.top_k = top_k

    def forward(self, x):
        # x: [tokens, dim]
        logits = self.gate(x)                      # [tokens, num_experts]
        probs = F.softmax(logits, dim=-1)
        topk = probs.topk(self.top_k, dim=-1)      # 每个 token 选 top-k 专家
        out = torch.zeros_like(x)
        for k in range(self.top_k):
            idx = topk.indices[:, k]               # 选中专家的下标
            w = topk.values[:, k].unsqueeze(-1)    # 对应门控权重
            out += w * self.experts[idx](x)        # 加权求和
        return out
真正工业级实现不会用上面的 Python for 循环,而是用聚合(grouping)或专家并行把 token 批量送进对应专家,否则路由开销会反噬稀疏激活省下的算力。Top-k 的取值本身是效果与算力的平衡点:k=1 时每个 token 只走一个专家,路由最稀疏但表达受限;k=2 是当下主流折中,能在不翻倍算力的前提下提升专家组合多样性。
三、MoE 与稠密模型的关键差异
理解了路由,就能看清 MoE 与 Dense 的本质区别。下面这张对照表是选型时最常问的几个维度:
| 维度 | 稠密模型 Dense | 混合专家 MoE |
|---|---|---|
| 激活参数 | 全部参数参与 | 仅 Top-k 专家激活 |
| 单次前向算力 | 高 | 低(只算激活专家) |
| 总参数量上限 | 受算力约束 | 可大幅扩展 |
| 显存占用 | 较低 | 高(需放下全部专家) |
| 训练稳定性 | 较稳 | 需负载均衡损失 |
四、训练的最大坑:路由坍塌与负载均衡
MoE 训练最棘手的问题是”路由坍塌”(Router Collapse):门控网络可能偷懒,把所有 token 都送给少数几个”明星专家”,导致其余专家形同虚设,模型退化为一个小稠密网络。为了防止这种情况,训练时通常引入负载均衡辅助损失(Load Balancing Loss),鼓励 token 均匀分派到各专家。
def load_balancing_loss(gate_probs, expert_idx, num_experts):
    # gate_probs: [tokens, num_experts]  softmax 后的概率
    # expert_idx: [tokens]              实际选中的专家下标
    one_hot = F.one_hot(expert_idx, num_experts).float()
    freq = one_hot.mean(dim=0)          # 各专家被选中的平均比例
    f_ip = gate_probs.mean(dim=0)       # 门控对各专家的均值概率
    return (freq * f_ip).sum()          # 越均衡,损失越接近 1 / N
除了均衡损失,工程上还有”专家容量”(Expert Capacity)的限制:每个专家每批能处理的 token 数有上限,超出会被丢弃或缓冲。容量设太小会丢信息,设太大又失去稀疏性,是部署时要反复调的超参。
五、主流 MoE 模型一览
当下开源与商用模型已大规模采用 MoE,下表给出几个代表性架构,方便你建立量级概念:
| 模型 | 专家数 | 激活 / 总参数 | 特点 |
|---|---|---|---|
| Mixtral 8x7B | 8 | 12.9B / 46.7B | 开源 MoE 先驱,单机可跑 |
| DeepSeek-V3 | 256 | 37B / 671B | 细粒度专家 + 共享专家 |
| Qwen3-MoE | 多档 | 多种规格 | 稠密 / MoE 双形态可选 |
| Llama 4 | 128 | 17B / 400B+ | Meta 多模态 MoE 架构 |
六、落地实战:本地推理怎么调用 MoE
对工程落地来说,最关心的还是”怎么把它跑起来”。以 vLLM 为例,它能自动识别 MoE 结构并做专家并行,调用方式和普通模型几乎一样:
from vllm import LLM, SamplingParams

# vLLM 自动识别 MoE,并把专家切分到多张卡
llm = LLM(model="mistralai/Mixtral-8x7B-Instruct-v0.1",
          tensor_parallel_size=2,        # 专家并行到 2 卡
          gpu_memory_utilization=0.9)

params = SamplingParams(temperature=0.7, max_tokens=512)
out = llm.generate(["用一句话解释 MoE 混合专家模型"], params)
print(out[0].outputs[0].text)
若显存吃紧,可结合量化手段把专家权重压下来。关于 GGUF 量化与 llama.cpp 的落地细节,可以参考 本地大模型量化部署;高吞吐推理服务的部署与调优则见 vLLM 部署实战。微调配 MoE 时,LoRA 也能只训练少量旁路参数,详见 LoRA 微调实战。
七、部署与显存注意事项
MoE 的”显存高、算力低”特性决定了它的部署画像:你需要的不是单卡极致算力,而是足够大的显存把全部专家 resident 下来。实践中常见策略包括专家并行(不同专家放不同卡)、激活量化,以及用推测解码进一步提速(思路可参考 推测解码实战)。
另外,MoE 与”小语言模型 SLM”是两条不同的降本路线:SLM 用更小的整体换速度,MoE 用稀疏激活换效果上限。选型时若追求端侧低延迟,可对比 小语言模型选型;若要强推理能力,则可结合 推理模型思维链 的算力调优思路。
最后提醒:MoE 的路由是黑盒的一部分,线上要关注”专家热度”监控,避免个别专家过载导致长尾延迟。建议上线前做一次专家负载压测:用真实流量分布跑一遍前向,观察各专家被选中的频次直方图,确认没有长尾专家饥饿或头部专家过载,把它当作一个需要可观测性的系统组件,而非单纯一个模型文件。
八、小结
MoE 混合专家模型用”多个专家 + 门控路由 + 稀疏激活”在参数规模和推理成本之间找到了甜点:参数可以很大,激活可以很小。落地时要重点盯住负载均衡、专家容量和显存规划三件事。掌握它,你就能更从容地选型、部署并优化当下主流的大模型架构。